
2026年以来,主流数据库厂商围绕AI的产品与战略发布明显提速。海外 Oracle 持续迭代 Agentic AI 增强的 Oracle AI Database,Google Cloud发布数据库智能体工具预览;国内 OceanBase、腾讯云、阿里云、华为云等厂商,也相继发布面向 AI/AI Agent 负载的数据库新版本。
这些发布共同指向一个变化:数据库厂商不再只回答“数据库能否支持AI”,而是开始回答“数据库能为AI承担多少数据准备和持续服务工作”。IDC认为,这轮竞争的关键,不只是增加多少AI功能,而是能否将企业数据转化为AI可持续使用、可治理、成本可控的业务上下文。从功能叠加走向可持续的数据供给,是当前AI原生数据库发展最值得关注的产业变化。
厂商密集发布的背后,是需求侧正在发生的结构性变化。当 AI 从演示走向生产,企业面对的不再是“要不要用 AI”的问题,而是“AI 能不能持续、稳定、成本可控地用上企业数据”的问题。数据规模、数据类型、数据消费方式都在改变,数据库作为企业数据的主要承载者,自然被推到了这轮变化的前台。也正因如此,AI 原生数据库才从一个产品概念,变成了一个需要被认真讨论的产业命题。
AI 工作负载重构需求,推动数据库迈向 AI 原生时代
国际数据公司(IDC) 相关调研结果显示,2025 年企业新生成的数据资产中约 90% 为非结构化数据,但大量数据散落在各类存储系统、各类业务系统之中,多模态数据相互割裂,企业手握数据 “富矿”,却缺少将数据转化为 AI 可用燃料的冶炼能力。
《IDC FutureScape: 全球 Agentic AI 2026年预测——中国启示》中提到,到2027年,未优先构建高质量AI就绪数据的企业将在扩展生成式AI和Agentic AI解决方案时面临显著挑战,导致生产力下降15%。
进入到2026年, 产业界已经形成清晰共识:AI 的竞争焦点正在离开大模型本身的能力演示,转向如何让企业存量海量数据真正服务于生产级 AI 业务。造成企业 AI 落地困局,本质是传统架构围绕结构化数据构建,难以应对海量非结构化多模态数据的处理需求。这些数据分散多系统带来副本冗余、版本不一致,极易引发 AI 输出失真。同时数据访问主体向 AI Agent 转变,原有架构缺少适配机器高频访问的安全、隔离与状态管理能力。此外传统治理体系无法覆盖向量、多模态数据,缺少将原始业务数据加工为 AI 可用上下文的完整链路。
为此企业需要数据库具备多模态混合检索、Agent 运行支撑、AI 链路治理以及成熟的企业级能力,支撑 AI 走向生产落地。这一产业现实,也让 AI 原生数据库的价值被推到台前。
向量能力只是入场券,不等于 AI 原生数据库。
增加一个向量检索能力,或者在管理控制台中接入一个对话助手,并不足以说明整个系统已经完成AI原生转型。判断“原生”程度,更有价值的观察标准是:当数据发生变化、模型需要替换、权限需要调整、负载出现波动时,这些能力能否在统一的管理机制下持续运行,还是仍需开发者在多个系统之间反复维护连接与同步关系。
因此,谈到AI原生数据库,不是要求数据库必须从零开发,也不是要求大模型必须运行在数据库进程内部,而是强调AI工作负载是否已经成为数据库架构设计的重要前提,而不再只是附加的使用场景。
AI需要的不是一堆数据,而是可用的业务上下文
向量搜索擅长发现语义相似的内容,但相似度本身无法判断数据是否满足时间、状态、金额等业务条件。例如一个售后服务Agent需要判断某笔订单能否退款,它不仅要找到一份语义相关的售后政策,还要核对订单时间、商品状态、客户身份、政策期限,以及操作权限。
这要求数据库具备标量与向量相结合的混合搜索能力,将结构化字段的精确匹配、范围过滤与向量相似度检索纳入同一查询过程,共同回答“哪些数据既相关,又满足当前业务条件”。对于企业AI而言,结构化查询并未因向量搜索的引入而失去价值,反而成为约束检索结果的重要基础。
因此,评估AI原生数据库,不能只看是否支持向量搜索,还需要看其能否融合标量与向量查询,并进一步承担多模态数据的组织与管理。真正的能力边界,不是“能检索多少种数据”,而是“能否将不同类型的数据组织为适合当前任务的业务上下文”。
Agent成为新用户,带来的不只是更多查询
IDC 预测,到 2031 年中国企业将拥有 3.5 亿个活跃智能体。
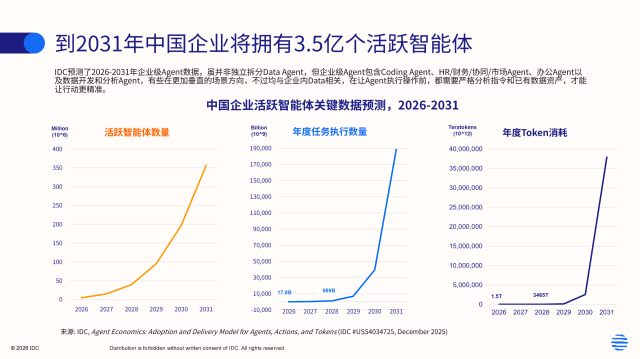
当数据库的服务对象拓展至持续执行任务的智能体时,数据访问需求将不再局限于单次查询。Agent 的长周期任务会反复读取数据、留存中间状态、调用业务工具,并依据返回结果持续迭代执行逻辑,这使得记忆与状态管理能力变得至关重要;面向 AI 开发场景,数据库环境的快速创建、隔离测试与回滚能力同样成为刚需。
由此看,AI与Agent并没有让数据库传统能力失去价值。相反,当数据被用于连续执行的业务流程时,事务一致性、资源隔离、故障恢复和可观测性依然非常重要,需要与新的检索、记忆和模型调用能力一起接受检验。
一体化正在升温,但不是把所有数据搬进同一个库
这一轮发布还有一个值得关注的共同点:厂商越来越少只发布一个孤立的检索功能,而是开始提供覆盖数据接入、处理、治理和应用服务的组合。在《IDC FutureScape:全球AI驱动的业务战略2026年预测——中国启示》中显示,到2027年,40%的企业将战略性投资AI融合的数据架构,以避免错误决策和竞争力下降。
面向AI工作负载,“一体化数据管理底座”的趋势愈发明显。但不能将“一体化”简单理解为“一个数据库替代所有系统”。对于企业,更重要的是减少重复的数据搬运、相互矛盾的业务定义和分散的权限管理,而不是追求产品数量最少。同样,支持开放格式或统一接口,也不意味着跨系统的一致性、性能和治理问题已经自动解决。企业仍需验证:数据更新多久可见,权限如何传递,多个引擎能否使用一致的业务定义,以及不同工作负载之间是否会相互影响。
“一体化”的价值应当体现在面相AI工作负载时的复杂度下降,而不是架构图上少了几个方框。
谁将受益,谁又面临压力?
根据《IDC Market Glance: 中国数据库管理系统,3Q26》报告显示,中国数据库管理系统涵盖了包括关系型数据库、多种非关系型数据库、数据仓库与湖仓一体、专用型数据库等等多类细分领域。当前,几乎所有细分领域的产品都在从不同“控制点”向面向AI的数据管理赛道演进。
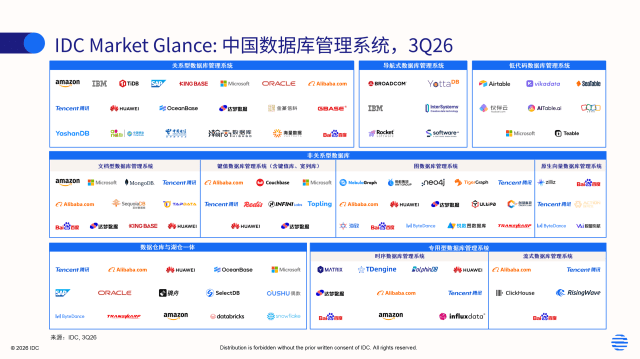
当前看来,拥有存量业务数据、成熟数据库能力和应用生态的厂商,具备向AI数据管理延伸的有利起点。但这种优势能否转化为新增收入,取决于它们能否降低客户的实际实施成本,而不只是把更多功能放入产品目录。
其他细分领域数据库厂商也并非没有发展空间。对于检索规模、响应延迟、数据类型或部署方式具有特殊要求的场景,专用产品仍可以提供更合适的方案。其竞争力是证明特定工作负载下的效果与成本优势,同时降低与企业现有数据体系对接的难度。但需要警惕的是,当向量生成、混合检索、模型调用和连接服务逐步被平台集成,单靠“支持某一项AI功能”建立的优势可能收窄。
真正被重构的,是数据库向AI提供价值的方式
从2026年以来的代表性发布看,数据库厂商正在同时回答两道题:如何借助AI改善数据库自身,以及如何让数据库更好地支撑AI。两者的交汇,使数据库的能力边界从存储与查询,进一步延伸至检索、上下文、记忆和受控的数据服务。
AI原生数据库的价值,不应由产品名称决定,也不应由演示中一次成功的问答证明。而是应该体现在,在复杂业务和持续变化的数据环境中,面向AI工作负载能稳定提供正确时间、正确范围内的数据,并让这一过程可管理、可追溯、成本可控。
IDC认为,未来的数据库竞争,不只是“谁能把数据管好”,还包括“谁能让AI持续、可靠、成本可控地把数据用好”。
进一步交流
如您希望进一步了解 IDC 对 AI 原生数据库、AI数据基础设施市场的规模预测、厂商格局及企业采用阶段的研究,或需要针对贵公司所在行业与目标市场进行定制化解读,欢迎与我们联系。